

分配任务
根据任务的依赖关系选择执行结构。
AI 的说明 / 示例
“所有测试都通过了。”
“构建没有问题。”
“全部修复了。”
哪些边界情况和测试结果支持所声称的修复?
说明性简报,并非客户结果。此托管模板仅审查提供的文本,不检查代码,也不验证正确性。
阅读完整审查简报 →从智能体、终端或 Python 工作流连接。每条路径都有独立的设置指南,可访问同一套托管执行记录。
查看连接方法 →答案只是故事的一部分。跟随智能体的工作,查看当时可用的检查,了解哪些地方仍需要你的关注。
选择一个节点即可查看其记录。
此演示无需注册,不会执行任何代码。
选择一个场景,然后跟随证据。
请审查范围外的配置变更以及未运行的检查。不会执行合并或选择。
模拟回放 / 已配置运行环境示例 / 非客户结果
一个审查层,而不是又一个编程智能体。
通过一个示例,了解提供的文本如何转化为审查简报和下一步行动。
添加 AI 的变更说明、目标和已检查的内容。所选模型只接收这些提供的文本。
阅读简短摘要、缺失信息和后续核查问题。请求、输出与运行状态保持关联。
查看建议的问题,自行检查代码并运行仓库所需的测试。模板不会执行这些检查。
目标
在合并前审查分页变更。
AI 变更说明
更新了游标分页并添加了回归测试。
已检查:仅检查了正常路径。
仓库代码和测试输出未检查
摘要:该变更声称修改了游标行为并增加了回归测试覆盖。
缺失信息:哪些边界情况和测试结果支持这一说法?
仅根据提供的文本生成的说明性输出。未检查仓库、代码或测试结果。
code_inspection: false创建账号,粘贴变更说明并添加目标和已检查的内容。简报由托管模型生成,无需配置提供商密钥。
审查我的变更说明此模板仅审查提供的文本,不检查仓库代码。托管模型费用已包含在套餐中;仓库检查需要单独配置的执行环境。
根据任务选择执行结构,提供可审查的输出与证据。

正在加载交互式 3D
点击、Enter 或空格暂停或播放。拖动或使用方向键旋转,Home 重置视角。这是装饰性可视化,不是实时执行数据。
根据任务的依赖关系选择执行结构。
查看一致与分歧;一致并不保证正确。
运行完成不等于代码检查通过。
多人一起审查 AI 编码代理的变更?Team 套餐共享一个工作区,并可通过 MCP、CLI 和 SDK 接入现有工具。仓库检查需要单独配置的执行环境。
AdaptOrch 是面向 AI 编码代理的托管审查层。它记录实际运行了什么、有哪些可用检查,以及哪些内容仍需人工审查。MCP 连接你的工具;代码库检查需要单独配置的执行环境。
Starter 每月免费提供 50 次运行。Pro 增加 500 次运行和 5 个 workspace 用户。已包含托管模型用量;自有密钥(BYOK)为可选项,其用量由该供应商另行收费。代码检查需要单独配置执行环境。
从智能体、终端或 Python 工作流连接。每条路径都有独立的设置指南,可访问同一套托管执行记录。
托管端点
https://adaptorch.com/mcp使用 AdaptOrch API 密钥认证并运行已包含的托管模型。BYOK 为可选项,其用量由该提供商另行收费。
终端设置路径
通过 AdaptOrch 服务认证
使用托管模型
提交一次,检查返回的记录
CLI 使用 AdaptOrch API 密钥认证并运行托管模型。BYOK 为可选项。请在指南中查看安装方式和支持的命令。
PYTHON 设置路径
通过 AdaptOrch 服务认证
使用托管模型
提交一次,检查返回的记录
Python 客户端使用 AdaptOrch API 密钥认证,并在托管模型上运行。请求成功并不表示代码检查已运行。
先选择接口,再单独配置执行范围。托管命令验证默认关闭;本地客户端并不等于自托管服务。
与你已经使用的工具并行工作


这些是兼容的工作流界面,标志不代表背书。
可用的托管路径
通过 MCP 或 API 提交模型任务,查看运行记录、输出和可用产物。Starter 是免费托管套餐。
单独配置 / 范围明确的 PoC
代码库和命令检查需要先明确环境、访问权限、检查命令及证据处理方式。升级托管套餐不会自动启用这些能力。
托管运行会将输入发送给 AdaptOrch 的模型服务商,代码不会只留在设备上。提交输入前请先阅读数据流说明。
数据、安全和运行责任 →说明性交互示例,此按钮不会运行客户代码或调用模型。
选择场景并回放展示步骤。演示使用固定示例数据。
Candidate patch modifies astropy/table.py to repair issue
                  behavior.
The patch applies cleanly, but we cannot call it correct. The test evidence came back inconclusive, and the shadow check flagged repair risk with no reproducible run behind it.
静态示例。选择重播,逐步查看记录。
重试也是工作。这个示例保留每一次尝试,未报告的成本绝不会被记为零。
平台方案与模型提供商费用分开计费。
| 调用 | 尝试 | 示例估算 |
|---|---|---|
| 草稿 | 01 | $0.0048 |
| 审查 | 01 | $0.0021 |
| 摘要 | 01 | $0.0005 |
| 草稿 | 02 | $0.0048 |
| 审查 | 02 | 未报告 |
| 摘要 | 02 | $0.0005 |
之前的尝试也会保留在记录中。
示意性的模型调用金额(美元),不是实时价格、账单或节省承诺。未报告的调用不计入小计,也绝不视为免费。
选择付费托管套餐前,先在 Starter 中试用自己的变更说明。需要更多每月运行额度或工作区用户时再升级。更高套餐并非正确性承诺。托管模型费用已包含在所有套餐中,只有使用自有密钥(BYOK)时才由该供应商另行收费。
运行使用 AdaptOrch 托管模型(WorkBuddy deepseek-v4.1-flash),所有含运行额度的方案均已包含。只需 AdaptOrch API 密钥即可。自带密钥(BYOK)仅作为希望使用自己服务商账户的 API 调用方的可选项。
可选的集合运行在已配置任务中调用您自己的 2–5 个模型。一次接收的运行使用一个套餐额度,供应商分别收取每个成员的令牌费用。费用取决于模型、令牌和尝试次数。工作区用户是人员而非模型成员,一致率不是准确性保证。
模型输出和 AI 解释属于 AI 生成内容,需要人工审查。不要将其等同于执行日志或实际运行的检查结果。
各方案功能
所有方案都使用托管模型运行并查看结果。Pro 和 Team 还会展示模型的推理过程,并用通俗的话解释这次运行。
| 功能 | 入门版 | 专业版 | 团队版 |
|---|---|---|---|
| 托管模型运行包含 deepseek-v4.1-flash · 无需提供商密钥 | 包含 | 包含 | 包含 |
| 答案与分步输出每次运行都会保存 · 附带新手阅读指南 | 包含 | 包含 | 包含 |
| 查看模型推理新功能主模型在回答前整理的笔记 | 不包含 | 包含 | 包含 |
| 通俗解释新功能用界面语言说明发生了什么、哪里出错、如何修复、接下来检查什么 · 每小时 30 次 | 不包含 | 包含 | 包含 |
模型推理和通俗解释由 AI 撰写,可能有误,也不是运行结果经过验证的依据。
年度金额为 USD 全年账单,不是月度扣款。Pro 每年 $421.20(月均 $35.10);Team 每年 $1,609.20(月均 $134.10)。Starter 不享受年度折扣。
托管套餐不会自动应用或合并代码库变更。单独配置的检查可在商定工作区中应用候选变更,人工审查和实际执行范围始终明确。
月度额度计算已接收的运行,不计算状态或产物查询。额度在接收时而非 SUCCEEDED 时使用。内部尝试属于同一运行,单独接收的重跑再次计数。供应商的令牌费用另计。
代码库命令检查需要单独配置执行环境。升级 Pro 或 Team 不会自动启用托管命令验证;配置和执行环境费用另行商定。
经济性 · 仅为估算。根据你自己的人工价值和成本假设,比较按月付费的托管订阅与自托管。节省效果尚未测量。
正在加载当前月度方案价格…
方案价格不可用,无法计算估算值。请查看下方的当前目录。
请选择方案,并完整填写有效的成本假设。不适用的成本请明确输入 0。
已根据你的假设更新估算。这不是实测节省。
max(0, subscription + extra_provider - self_host_infra) /
                    hourly * 60
subscription、extra_provider 和 self_host_infra 分别为每月订阅费、额外服务商支出和自托管基础设施成本(USD);hourly 为每小时人工价值(USD)。结果以每月分钟数表示,下限为零。
这是根据输入条件达到收支平衡所需的每月人工时间减少量,不是实测节省时间,也不是完整 TCO。我们不会按小时数或 PR 数量推荐方案。
使用当前每月 USD 价格,而非年度促销价。不包括税费及两种工作流共同承担的模型成本。初始设置和持续维护并未全部计入,实际总成本可能不同。
检查变更范围、实际运行的检查、测试变更和执行环境失败。
阅读已收集的失败证据。不明确的失败仍需审查,不代表补丁安全。
查看执行轨迹 →通过仅限记录的检查,不代表可以合并。仍需人工审查。
代码库检查需要单独配置执行环境。托管文本审查不运行代码库命令。PASS 仅限记录的检查,未运行的检查仍是未运行。
在运行历史中查看状态、模型信息和可用产物。代码库检查需要单独配置执行路径。
代码库检查取决于选定的环境和命令。运行前商定文件访问、网络权限和隔离方式。记录可用于与 CI 比较,但一个环境中的通过不保证另一个环境也通过。
临时工作空间与保留的报告是不同数据。工作空间按执行环境配置清理,运行记录、日志和产物遵循公布的保留政策。
执行与证据边界 →利用已有执行证据决定需要再次检查什么。这些是审查问题,不是每次运行都能检测所有问题的保证。
变更前后的复现有助于评估修复;若缺失,应注明其他证据和仍需测试的行为。
对照声明任务范围审查记录的文件与变更。配置的验证路径可帮助发现无关修改。
删除或削弱测试可能改变通过结果的含义。请将测试变更与命令结果一起审查。
分别审查配置、网络和测试结果。缺失命令与超时可被分类,模糊失败仍需诊断。
结果仅适用于各自声明的实验范围。请同时查看正面结果、遗漏和方法限制;这不是对客户代码库性能的承诺。
AdaptOrch 研究论文讨论面向任务的多智能体编排。托管产品与 CEK 代码库验证流程各有执行限制;论文结果不能证明客户代码的正确性或托管性能。
AdaptOrch: Task-Adaptive Multi-Agent Orchestration in the Era of LLM Performance Convergence · Geunbin Yu · submitted 2026-02-18
改善与退步的记录可在证据 JSON 中查看。
每个方块是一项已记录的合成任务。绿色表示检查通过;红色边框表示 C 组相对 A 组退步的结果。
30 项合成账本任务:paper 基线 A 与 robust + verifier C 相比,8 项改善,1 项退步。合成和验证设置都不同,因此并非仅验证器效果的对照实验。
本地执行已测量,人工时间节省尚未测量。请将这些结果与基于假设的成本估算分开看待。
本实验使用可信的本地对照条件,测量 CommandVerifier 的创建、执行与分类耗时,没有调用模型 API。这并不是对实际 AI 生成补丁的验证。
正在加载本地测量数据…
本地数据已加载。下方显示所有结果,包括不匹配项。
无法加载测量数据,暂不显示任何结果。请下载 JSON 直接检查。
在本地重复执行五个固定的合成对照条件。重复次数不代表独立开发者或任务。匹配数是符合预期分类的次数,不是缺陷检测准确率。需要时可在表格内横向滚动;键盘用户可聚焦表格后使用方向键。
| 对照条件 | 预期分类 | 观测分类(次数) | 中位数(毫秒) | p95(毫秒) | 匹配 / 尝试(次数) |
|---|---|---|---|---|---|
| 通过的断言分类不匹配 | — | — | — | — | — |
| 失败的断言分类不匹配 | — | — | — | — | — |
| 缺少可执行文件分类不匹配 | — | — | — | — | — |
| 故意触发超时分类不匹配 | — | — | — | — | — |
| 缺少 Python 依赖分类不匹配 | — | — | — | — | — |
分类不匹配:缺少依赖的对照条件预期为 ENV_ERROR,实际观测为 FAIL。不匹配的尝试仍保留在耗时汇总与可下载数据中。
已知局限:缺少 Python 依赖被误分类为普通测试失败。分类器并不能将所有环境故障与候选代码故障区分开来。
这些结果不是托管服务的往返延迟测量,不是安全隔离测试,也不是实际 AI 补丁验证。共享托管的命令验证默认关闭。命令组件既不复制项目,也不应用补丁。
执行前已固定协议:每个对照条件重复 20 次,用种子 20260905 打乱顺序;每次尝试使用新的验证器,不使用缓存,执行一条命令,超时上限为 0.35 秒。
固定对照条件共有五个:关于 2 + 2 的 Python 断言通过与失败、缺少可执行文件、原定 2 秒的休眠在 0.35 秒被终止,以及导入不存在的 Python 模块。这些简单测试输入并非 AI 生成补丁或真实项目测试套件;毫秒级耗时不代表真实项目测试延迟。
可信测试输入在临时工作目录中运行,使用默认资源限制且不继承环境变量。临时目录不是项目的干净副本,也不是安全边界。
使用单调时钟测量验证器创建、命令执行和分类的实际经过时间。不包括测量程序启动、报告序列化及网络延迟。
保留所有尝试,包括较慢及出错的尝试。中位数与 nearest-rank p95 仅为描述性统计,不进行显著性检验、不估算可推广的准确率,也不作因果性的节省声明。
JSON 记录源码修订版本、工作树变更状态、源码哈希和环境元数据。这是内部执行前协议,不是外部预注册或发布批准。
这里没有人工评审研究或客户节省数据。本地命令耗时无法说明开发者节省了多少评审时间。
在声称节省之前,必须在相同任务上配对测量手动与辅助工作流的实际评审活动时间,单独记录等待时间,独立核验正确性,并记录真实的订阅、服务商、基础设施、设置及维护成本。应纳入独立开发者与代码仓库,随机安排工作流顺序,并保留失败或更慢的运行。
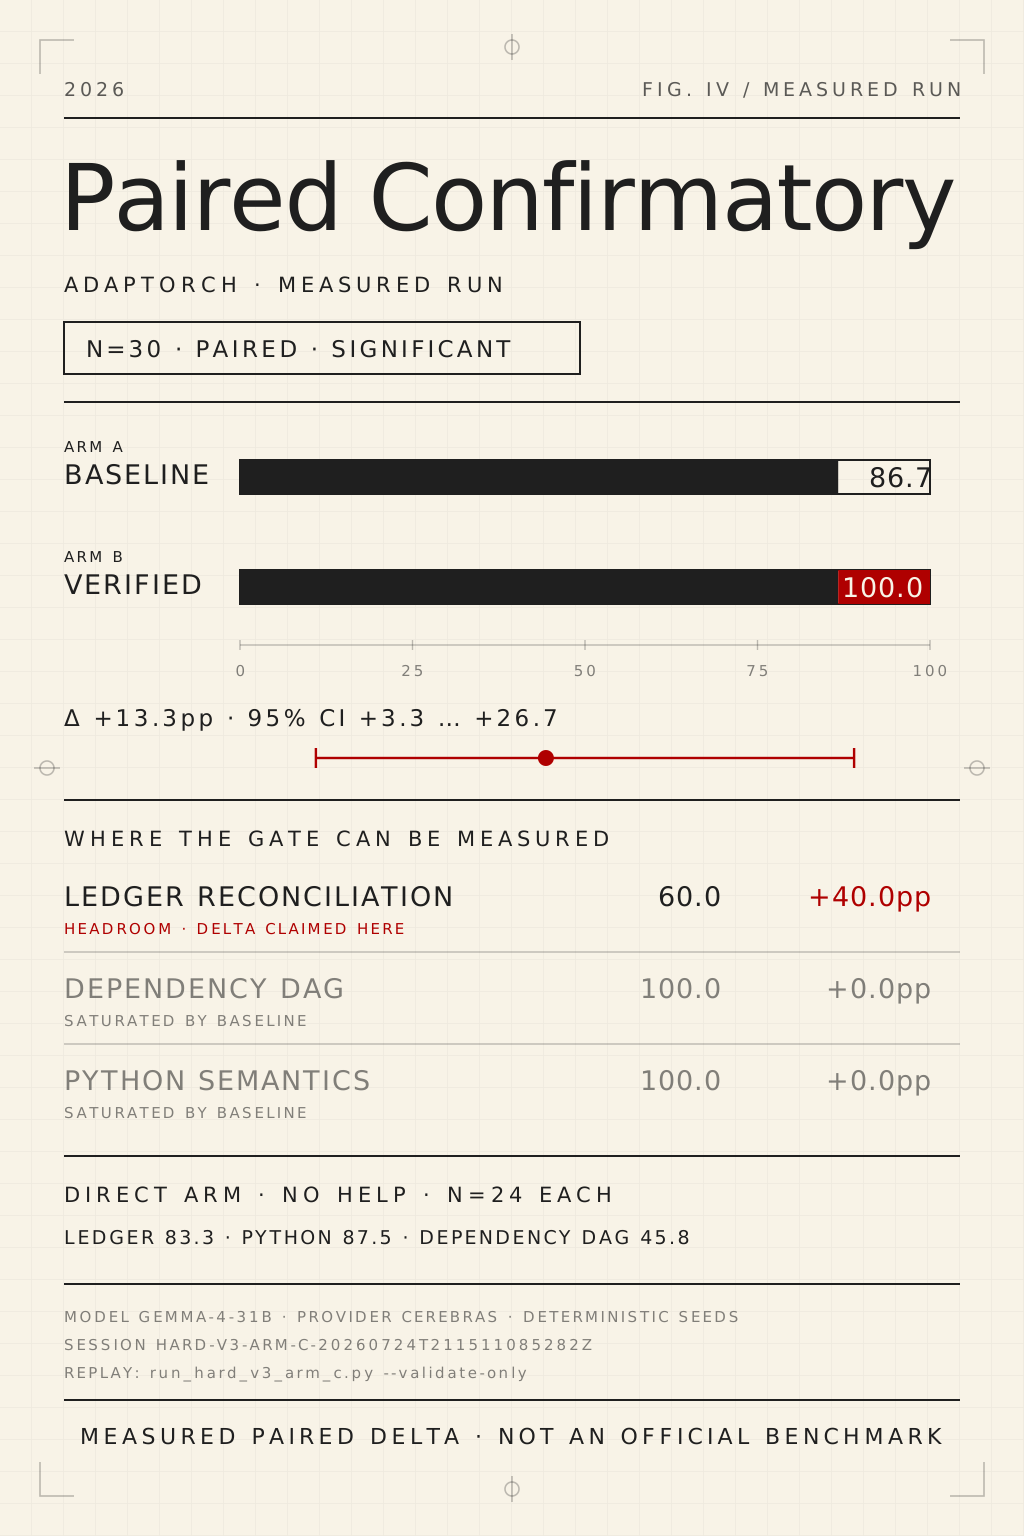
paired_confirmatory_ledger:30 项合成账本任务,一次配对会话。基线 86.7%,验证后 100.0%,差值 +13.3pp(95% CI +3.3 至 +26.7)。合计判定未达显著,族门未通过:方向性结果,而非已证实。它与A/C 账本是不同实验。
本次 20 道 ARC-AGI-2 题实验中,最强单模型答对 14/20,精确答案投票答对 10/20,且费用更高。这是一次内部实验,不是普遍结论。
公开汇总包括错误与截断数。GPT 评分 16 项、错误 4 项;Qwen 评分 19 项、截断 1 项。评分分母与最强单模型及投票组不同。
记录中的模型调用成本(USD),为三个成员组费用之和。不是客户账单或完整 TCO;该记录未确认额外收费。
three-way-20260826T142538Z
公开数据是汇总而非逐题配对结果,无法独立确定改善和退步各有多少项。
n = 20 · 描述性汇总比较,不是通用性能声明。
检查通过只覆盖实际执行的条件,不代表整体正确性、安全性或未测试条件下的行为已经得到证明。
运行凭据展示已记录的证据。未执行验证的运行不等于测试通过。上面的本地实验测量命令检查,不能证明托管补丁执行或开发者节省了时间。
我们也公开不利结果。合成账本 A/C 对比中,8 项改善、1 项退步。这同时比较了合成和验证设置,并非仅验证器的效果。
如果这个页面上有任何承诺超出了我们能展示的证据,告诉我们,我们会改页面。
通过 MCP 或 API 提交模型任务,查看记录、输出和可用产物。共享托管命令验证默认禁用;代码库检查需要独立执行环境。
我们不提供代码整体正确性的证明。请核对实际执行了哪些验证、记录了哪些证据。没有执行测试的模型运行成功,不等于测试通过。
默认托管流程不会自动应用或合并客户代码库中的变更。独立配置的验证环境可在商定的工作区中应用候选变更以供检查;审查决定仍由客户负责。
当前表格展示五种固定对照输入的本地命令检查耗时。历史台账实验测量的是另一种操作。两者都不能证明你的仓库延迟、托管端到端延迟或开发者节省的时间。
本地对照实验区分了缺失可执行文件与超时,但缺失 Python 依赖被归为普通测试失败。失败标签需要结合上下文,不能保证诊断所有环境问题。
一次接收的运行使用一个额度。状态、用量和产物查询不会创建新运行。完成不是计数触发点,单独接收的重跑再次计数;已包含托管模型用量;自有密钥(BYOK)为可选项,其令牌费用由该供应商另行收费。
不是。模型可能在没有代码检查的情况下完成。请查看实际命令、结果及跳过或未测试部分;AI 解释不能代替这些记录。
使用适合客户端的文档化 MCP 或 HTTP 连接方式。认证、模型执行和代码库验证是不同步骤,需要分别确认。
报告展示执行记录及可用验证证据。变更文件、前后测试和重跑信息取决于配置路径;缺失的检查必须保持明确。
公开 Starter 连接托管 AdaptOrch。在本机运行客户端不等于自托管服务。如需内网部署,请咨询单独的私有运行器选项。
托管请求经过 AdaptOrch 和你配置的 AI 服务商。提交私有代码前请查看数据传输和保留政策。私有运行器是单独部署,并非 Starter 默认配置。
默认托管服务不包含自动合并。任何主动阻断策略都需根据客户环境和审查政策单独配置及评估。
AdaptOrch 是用于审查 AI 智能体运行记录、模型输出和可用验证证据的托管服务。通过 MCP 或 API 连接编码工具。代码库检查需要单独配置的执行环境。
Geunbin Yu 的论文“AdaptOrch: Task-Adaptive Multi-Agent Orchestration in the Era of LLM Performance Convergence”于 2026 年 2 月 18 日提交至 arXiv,编号为 2602.16873。研究结果与托管产品及 CEK 代码库验证流程应分别看待。
在 arXiv 阅读 AdaptOrch 论文 →不要只看最终回答,要检查运行记录:实际运行了什么、记录了哪些命令或测试、是否有变更前失败而变更后通过的复现、是否改动了无关文件、测试本身是否被修改。通过的检查只覆盖它实际执行的范围,并不等于正确性保证。
代理运行记录是一次执行的持久历史,包括输入、所选模型、工具或命令步骤、输出、状态和可用产物。AdaptOrch 保存托管运行记录,让审查者之后可以检查,而不必依赖聊天记录。
AdaptOrch 是面向 AI 编码代理的审查层,不是另一个写代码的代理。它记录执行证据和可用检查,供人工审查变更。它补充代码审查和 CI,不替代它们,也不证明代码正确。
不是直接替代。CodeRabbit 和 Copilot code review 会在拉取请求上留下评论。AdaptOrch 是面向 AI 编码代理的审查层,记录代理运行了什么、有哪些可用检查,供人工审查变更。它补充代码审查和 CI,可以与这两种工具一起使用。
查看 AdaptOrch 与其他 AI PR 审查工具的对比 →默认不会。托管文本模板读取你提供的文本,例如变更说明、目标和现有检查,并返回摘要、缺失信息和审查问题。它不检查代码。仓库检查需要单独配置的执行环境,以 PoC 形式提供。共享托管命令验证默认关闭。
Starter 免费,每月 50 次准入运行。Pro 每月 $39,含 500 次运行和 5 个工作区用户。Team 每月 $149,含 2,500 次运行和 15 个工作区用户。这些套餐已包含托管模型用量。自有密钥(BYOK)为可选项,其用量由该提供商另行收费。
说明需要验证的问题。先确认执行限制,再在代码库工作前商定范围、交付物和价格。